IBMは2026年10月21日、Hugging Face上で音声モデル群「Granite Speech」の3つのアップデートを公開しました。新モデル「granite-speech-5.0-2b」は日本語を含む6言語の文字起こしに対応し、高速な「Turbo CTC」の多言語化や、話者識別に強い「4.1 2B Plus」の改良も行われています。
Granite Speech 5.0の概要:3つのモデルが同時に更新
IBMのGraniteチームは、音声モデルコレクション「Granite Speech」に関する3つのアップデートを発表しました。1つは新しい音声言語モデル「granite-speech-5.0-2b」、残る2つはすでにコミュニティで利用されている「granite-speech-5.0-470m-turboctc」と「granite-speech-4.1-2b-plus」の改訂版です。
IBMによると、これら3モデルを組み合わせることで、高精度な文字起こしと翻訳、エッジ環境での極めて高速な文字起こし、そして「誰が・いつ話したか」が内容と同じくらい重要な録音の処理まで、企業の音声業務を幅広くカバーできるとしています。
| モデル名 | 区分 | 主な特徴 | 適した用途 |
|---|---|---|---|
| granite-speech-5.0-2b | 新規 | 高精度で雑音・残響に強い音声認識、言語指定プロンプト、最大2,000語のキーワードバイアス、長文翻訳の改善 | 高精度な多言語の文字起こしと翻訳 |
| granite-speech-5.0-470m-turboctc | 更新 | 多言語化、句読点・大文字小文字のネイティブ出力、雑音・残響への耐性向上 | 大量処理やオンデバイスでの文字起こし |
| granite-speech-4.1-2b-plus | 更新 | 話者識別、タイムスタンプ、キーワードバイアス、長時間音声の性能向上 | 会議、通話など複数話者の録音 |
新モデル「granite-speech-5.0-2b」:日本語の文字起こしに対応
granite-speech-5.0-2bは、「granite-speech-4.1-2b」の後継モデルで、パラメータ数は同じ規模(2B)です。文字起こしの対応言語は英語、フランス語、ドイツ語、スペイン語、ポルトガル語、日本語の6言語です。翻訳については、これらの言語と英語の双方向に加え、英語からイタリア語、英語から中国語(標準中国語)への翻訳にも対応しています。
学習には39万時間分の公開音声データが使われており、さらに日本語の音声認識、キーワードバイアス、翻訳向けに作成された合成データも用いられています。
4.1 2Bからの主な改良点
- 英語音声認識の精度と頑健性の向上:英語の短い発話を対象としたベンチマークで精度が上がり、雑音、残響、離れたマイクで録音された音声への対応も改善されました。
- 言語指定プロンプト:入力音声の言語をプロンプトで指定することで、多言語の文字起こしを制御できます。
- 長文・会話の翻訳品質の向上:短い読み上げ文だけでなく、より長く自然な話し言葉でも翻訳品質が保たれるようになりました。
- 最大2,000語のキーワードリスト:製品名、人名、略語などに向けて文字起こしや翻訳を寄せることができ、すべての対応言語で利用できます。
- 句読点と大文字小文字の出力指定:プロンプトで整形済みの出力を指示でき、大文字小文字の正確さを示すF1スコアはテストセット全体で89.7〜99.5の範囲とされています。
英語の平均WERでオープンモデル2位
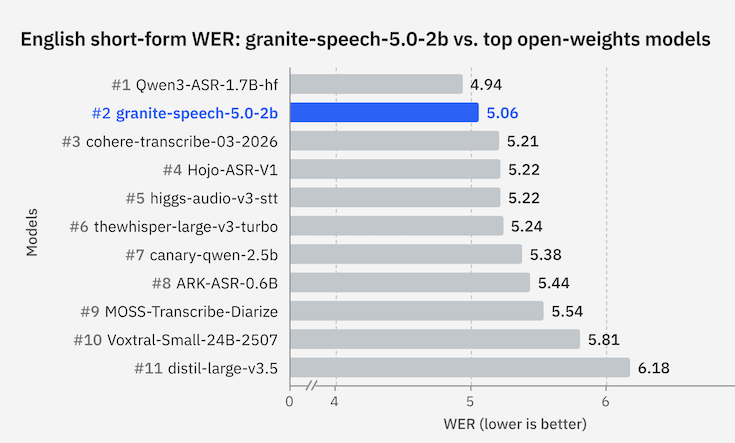
公開されたグラフによると、granite-speech-5.0-2bは英語の平均単語誤り率(WER)が5.06%で、主要なオープンウェイトの音声認識モデルの中で2位に位置しています。なお、この結果は非公式なもので、2026年10月15日時点、Open ASR Leaderboardの英語短文テストセットの平均値と説明されています。
ライセンスはApache 2.0で、Transformers、vLLM、llama.cpp、そしてApple Silicon向けのmlx-audioでの利用に対応しています。
「Turbo CTC」が多言語化し、さらに高速に
granite-speech-5.0-470m-turboctcは、2026年8月に英語専用・4億7,000万パラメータの高速エンコーダーとして登場したモデルです。今回の改訂では同じサイズを維持したまま、ユーザーからの要望が多かった3点が追加されました。
- 多言語の文字起こし:英語、日本語、スペイン語、ドイツ語、フランス語、イタリア語、ポルトガル語に対応しました。
- 句読点と大文字小文字のネイティブ出力:別途の句読点付与や大文字小文字の補正処理を行わなくても、そのまま読める形で出力されます。
- 難しい音響環境への耐性:残響のある音声を明示的に対象とした学習により、反響の多い部屋や離れた位置での録音に強くなりました。
速度面も向上しています。単一のConformerブロックをコンパイルし、そのグラフを全層で再利用することでウォームアップ時間を短縮しました。その結果、Open ASR LeaderboardでのRTFx(数値が大きいほど高速)は、公開時の約12,600から19,870に向上しています。同等の精度を保ったまま、約1.6倍の高速化を実現したとされています。
「granite-speech-4.1-2b-plus」:誰が・いつ話したかをより正確に
granite-speech-4.1-2b-plusは、会議やサポートコール、インタビューなど、複数の話者が長時間話す、企業が実際に扱う録音向けに調整されたモデルです。アーキテクチャ、プロンプト形式、APIは変更されていないため名称は「4.1」のままで、重みを改善した版として既存モデルとそのまま置き換えて使えます。
今回の改訂では、次の4つの領域が改善されました。
- 話者識別:単語単位の話者誤り率(WDER)が7%、話者を考慮した単語誤り率(cpWER)が全体で7%低下しました。
- タイムスタンプ:平均タイムスタンプずれ(AAS)が半分以下になり、字幕や検索、レビューでのタイミングがより正確になります。
- 長時間音声の性能:長文テストセットでのWERが24%低下しました。
- キーワードバイアス:20語のキーワードリストを使った場合、対象キーワードの誤りが45%減少しました。
| 項目 | 指標 | 従来版 | 更新版 |
|---|---|---|---|
| タイムスタンプ(全音声) | AAS | 210.86 | 98.54 |
| タイムスタンプ(短い音声) | AAS | 29.27 | 26.20 |
| キーワードバイアス | 対象語のWER(20語リスト) | 11.79 | 6.48 |
| 長時間音声 | WER(長文テストセット) | 13.53 | 10.22 |
| 話者識別 | WDER | 4.40 | 4.10 |
| 話者付き文字起こし | cpWER | 30.50 | 28.48 |
※いずれも誤り率の指標で、数値が低いほど良い結果を示します。
どのモデルを選ぶべきか
IBMは用途に応じて、次のようにモデルを選ぶことを勧めています。
- 高い文字起こし精度、翻訳、キーワードバイアスが必要な場合:granite-speech-5.0-2b
- 処理速度やオンデバイスでの文字起こしを重視する場合:granite-speech-5.0-470m-turboctc(ブラウザで試せるWebGPUのストリーミングデモも用意されています)
- 会議や複数話者の通話を扱う場合:granite-speech-4.1-2b-plus
3モデルはいずれもApache 2.0ライセンスで公開され、Transformersにネイティブ対応しています。詳しい評価結果やアーキテクチャ、学習データ、使用例は