イレブンラボは、医療分野向けの音声認識モデル「Scribe v2 Medical」を、バッチ処理のSpeech to Text APIで正式に提供開始しました。薬剤名や医学用語の認識に特化したモデルで、公開の医療ベンチマークでは単語誤り率7.0%を記録し、医療用語のハルシネーションも0.4%に抑えています。
医療向け音声認識モデル「Scribe v2 Medical」を正式提供
イレブンラボ(CEO:Mati Staniszewski)は2026年10月1日、医療分野向けの音声認識(Speech to Text)モデル「Scribe v2 Medical」を、バッチ処理のSpeech to Text APIで正式に提供開始したと発表しました。
同モデルは2026年5月から先行提供されてきたもので、薬剤名、解剖、病理、臨床の口述筆記といった、診療に関わる音声の認識精度を高めています。
「Scribe v2 Medical」とは
「Scribe v2 Medical」は、汎用の音声認識モデル「Scribe v2」を医療向けに追加学習したモデルです。臨床の現場で生まれる、次のような音声を対象としています。
- 診療中の会話の記録
- 医療スクライブ(診療記録の作成補助)
- 口述筆記
- 問診
- 医療機関間の連携に伴う通話
音声をテキストに変換するモデルであり、診断は行わない
このモデルは、診療中の会話や口述をテキストに変換する音声認識モデルです。カルテや診療記録の文書そのものを生成したり、診断・治療方針を判断したりするものではありません。出力は、医療従事者などの権限を持つ利用者が確認・修正したうえで使用することを想定しています。
顧客である医療AI企業は、このモデルを音声認識の土台として、その上に自社の記録作成サービスや診療支援製品を構築します。
また、「Scribe v2」を土台としているため、医療以外の一般的な音声に対する認識精度はそのまま保たれています。精度の検証は現在、英語、フランス語、ドイツ語で実施されています。
認識精度:3つの観点で検証
認識精度は、公開ベンチマークを用いた評価と、医療AI企業Nablaによる第三者評価で確認されています。主な結果は次の3点です。
1. 医療音声の書き起こし精度:単語誤り率7.0%
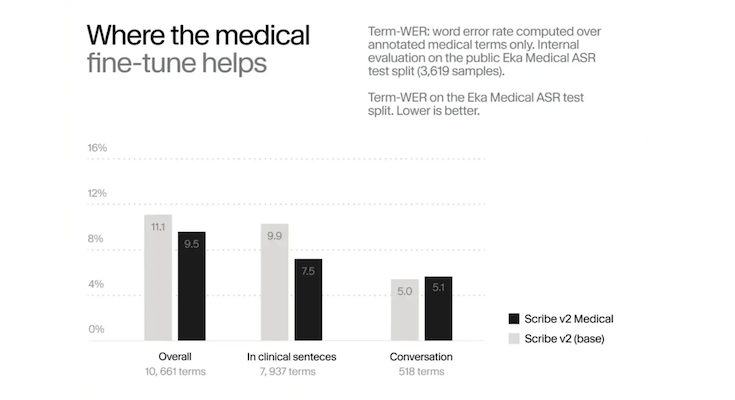
公開の医療ベンチマークであるEka Medical ASRテストセット(実際の臨床音声3,619件)で、書き起こした単語のうち誤りの割合を示す単語誤り率は7.0%でした。同じテストでの各モデルの結果は以下のとおりです。
- Scribe v2 Medical:7.0%
- Scribe v2(ベースモデル):8.6%
- Scribe v1(前世代):18.6%
追加学習のベースとなった「Scribe v2」に対して単語誤り率は1.6ポイント低下し、前世代の「Scribe v1」と比べると半分以下になりました。
2. 医療用語のハルシネーション:0.4%に低減
AIによる音声認識では、実際には話されていない言葉を書き足してしまう現象(ハルシネーション)が起こり得ます。医療の記録では特に避けなければならない誤りです。
医療AI企業Nablaによる第三者評価では、医療用語でこの現象が起きた割合は0.4%で、「Scribe v2」の0.7%からさらに減少しました。また、実在しない薬剤名を作り出すといった誤りはゼロで、残っていた誤りは実在する単語の綴りの間違いでした。
3. 一般的な会話音声の精度は維持
医療に特化したことで日常的な会話の認識が苦手になっていないかも検証されています。一般的な会話音声のテスト(CommonVoice、6,000件)の成績は「Scribe v2」と同じ5.3%で、精度の低下は見られませんでした。
また、医師の口述筆記を対象としたテスト(Corti MedDictate)では、英語・フランス語・ドイツ語を対象とする評価で、ベースモデルの「Scribe v2」と比べて単語誤り率が相対的に約36%低下しました。
セキュリティとデータの取り扱い
エンタープライズ契約の顧客は、BAA(Business Associate Agreement)を締結し、Zero Retention Mode(ZRM)を有効化することで、HIPAAに対応した形で利用できます。
ZRMはAPI経由で設定でき、有効化したリクエストでは、処理完了直後に入力音声と出力テキストが削除されます。顧客のシステムが受け取った文字起こしデータの保存・管理は、顧客側で行います。
イレブンラボは、医療分野の音声という最も慎重な扱いが求められるデータを預かることを前提に、このモデルを設計したとしています。
主なポイント
- 医療分野向け音声認識モデル「Scribe v2 Medical」を、バッチ処理のSpeech to Text APIで正式提供
- 汎用モデル「Scribe v2」を医療向けに追加学習
- Eka Medical ASRテストセットで単語誤り率7.0%(Scribe v2は8.6%、Scribe v1は18.6%)
- Nablaの第三者評価で、医療用語のハルシネーション率0.4%(Scribe v2は0.7%)
- 一般会話音声の精度は「Scribe v2」と同等の5.3%を維持
- 精度検証は英語、フランス語、ドイツ語で実施
- BAA締結とZRM有効化でHIPAAに対応した利用が可能
イレブンラボについて
イレブンラボは、2022年に設立されたAI研究・プロダクト企業です。企業向けの音声・チャットエージェントプラットフォーム「ElevenAgents」、コンテンツの制作・編集を支援する「ElevenCreative」、開発者がAIオーディオ基盤モデルを利用できる「ElevenAPI」を提供しています。音声合成、音声認識、会話型AIなどを通じて、企業、開発者、クリエイターによる新たなコミュニケーション体験の構築を支援しており、プラットフォームはFortune 500企業の80%以上を含む数千社に利用されています。
参照元: https://prtimes.jp/main/html/rd/p/000000069.000160611.html